Dans cet article
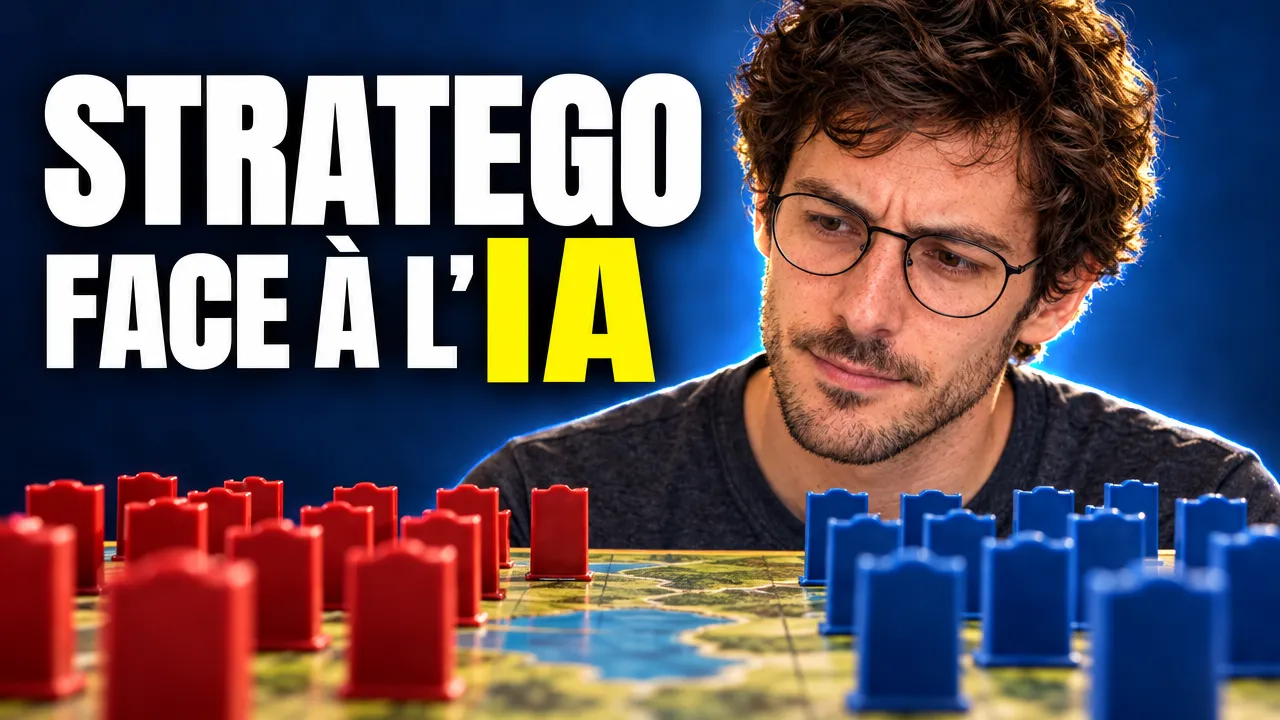
Ataraxos, une IA de jeu étudiée notamment au MIT, a remporté 15 des 20 parties contre Pim Niemeijer. La confrontation s’est déroulée en juillet 2025, sur trois semaines. Le joueur humain a obtenu une victoire et quatre nulles.
Ce résultat montre une capacité précise : décider efficacement face à un adversaire dont les pièces restent cachées. Les conditions du match et les moyens de calcul permettent d’en mesurer la portée.
Pourquoi les pièces cachées compliquent-elles le calcul ?
Stratego oppose deux joueurs disposant chacun de 40 pièces. Leur identité reste cachée à l’adversaire jusqu’aux affrontements. Les configurations initiales possibles dépassent 10³³, contre 1 326 mains initiales au Texas Hold’em, une variante du poker.
Ce nombre donne l’échelle de l’incertitude initiale. Une IA doit envisager plusieurs dispositions adverses, puis réviser leur probabilité au fil du jeu.
La difficulté tient aussi à l’historique des décisions. La valeur d’un coup dépend des stratégies futures et des choix antérieurs. Ces choix influencent les probabilités attribuées aux pièces cachées.
Un déplacement renseigne donc à la fois sur la position et sur les intentions possibles de l’adversaire. Une recherche efficace doit conserver cette incertitude, sans traiter une hypothèse comme une certitude. Les parties peuvent durer plusieurs centaines de coups.
Ataraxos apprend une stratégie, puis simule avant de jouer
Ataraxos apprend par autojeu : le système progresse en jouant contre lui-même. Cet apprentissage produit une politique de jeu, c’est-à-dire une stratégie qui associe une situation à des actions possibles.
Le système ajuste conjointement deux paramètres pour stabiliser cet apprentissage. La régularisation encadre l’évolution de la stratégie ; la taille des mises à jour règle l’ampleur de chaque modification.
Pendant une partie, Ataraxos utilise aussi un réseau de croyance. Ce modèle génère des configurations plausibles des pièces adverses. L’IA s’appuie sur ces hypothèses pour simuler les conséquences de ses actions avant chaque décision.
Pendant l’évaluation, cette recherche explorait 1 000 trajectoires sur 40 demi-coups, chacun correspondant au mouvement d’un seul joueur. Une décision prenait environ 1,26 seconde.
Une autre IA avait déjà atteint un niveau élevé à Stratego. DeepMind, le laboratoire d’IA de Google, annonçait en décembre 2022 les performances de son système DeepNash. Celui-ci avait atteint le top trois historique de Gravon, une plateforme de jeu en ligne.
DeepNash apprenait également par autojeu, sans explorer un arbre de coups ni modéliser explicitement les pièces cachées adverses. Ataraxos apporte donc une approche différente : combiner une stratégie apprise avec une planification fondée sur des hypothèses probabilistes.
Le joueur pouvait s’adapter, l’IA restait fixe
Niemeijer pouvait modifier sa stratégie entre les parties. Il savait qu’Ataraxos ne s’adapterait pas à son style. Le match testait donc aussi la résistance d’une stratégie fixe face à un humain capable d’en rechercher les faiblesses.
La participation était rémunérée : 1 000 dollars, puis 100 dollars par victoire et 50 dollars par nulle. Ce dispositif ajoutait une incitation financière aux résultats obtenus.
Les auteurs annoncent un score de 85 %, en comptant chaque nulle comme une demi-victoire. La proportion de parties effectivement gagnées atteint 75 %. Cette distinction évite de confondre score et taux de victoire.
Les auteurs précisent aussi que les résultats ne constituent pas des essais indépendants réalisés dans des conditions identiques. L’adaptation du joueur humain relie les parties entre elles. Ces 20 rencontres documentent une confrontation gagnée, sans garantir le même résultat face à tout adversaire.
Un seul processeur pour jouer, plusieurs pour apprendre
Ataraxos disputait le match sur un seul H100 de Nvidia, fabricant de processeurs. Ce GPU, un processeur destiné au calcul parallèle, assurait les simulations nécessaires aux décisions.
L’entraînement final mobilisait davantage de matériel : 16 H100 pendant une semaine. Le réseau de croyance nécessitait ensuite quatre H100 pendant quatre jours. La ressource utilisée pour jouer ne résume donc pas le coût de préparation du système.
Le dépôt public fournit le code d’autojeu et de recherche sous licence MIT, une licence permissive. Il propose des scripts séparés pour entraîner la stratégie et le modèle de croyance, ainsi que des modèles préentraînés.
Les prérequis annoncés comprennent Linux et un GPU compatible avec CUDA 11.8, l’environnement de calcul de Nvidia. Pour un développeur, le code disponible facilite l’étude du système. Reproduire l’entraînement décrit suppose toutefois de disposer des ressources correspondantes.
La victoire valide une méthode dans un cadre délimité
Ataraxos démontre l’efficacité d’une combinaison : apprendre une stratégie, estimer l’information cachée et simuler avant d’agir. Son succès porte sur Stratego et sur les conditions d’évaluation décrites.
Les chercheurs envisagent des applications aux négociations commerciales et à la cybersécurité. Ces usages restent des pistes. Leur méthode dépend notamment de simulateurs rapides et précis, capables de représenter les situations étudiées.
Gabriele Farina, chercheur impliqué dans le projet, souhaite aussi rendre les décisions interprétables et auditables avant une adoption réelle. Il reste donc à vérifier la qualité des simulations hors du jeu et la possibilité d’expliquer les choix du système.